"当地要求数据必须留在本地,可总部又要看全球数据——这不矛盾吗?"这是IT负责人在架构设计会上最常被问到的问题。看上去左右为难,其实是个可以拆解的设计题。
本地存储与总部可见并不天然冲突。可行的路子是"多站点部署 + 分级用数":明细数据留在当地满足驻留要求,统一口径汇到总部满足经营可见。数据在哪儿存、谁能看什么,是两个可以分开设计的问题。
很多人觉得本地存储是个死结,是因为把两件事混在了一起。
第一件事:数据存在哪里。 这由属地法规和业务要求决定。某些国家要求特定数据必须存储在境内,这是硬性约束,架构必须满足。
第二件事:谁能看到什么。 这由管理需要决定。总部需要看全球经营口径,但不等于要看每一条境外明细数据。它要看的是汇总后的、口径一致的经营管理信息。
把这两件事分开,矛盾就化解了:数据留在当地,口径汇到总部。明细不出境,汇总可上收,两者可以兼得。
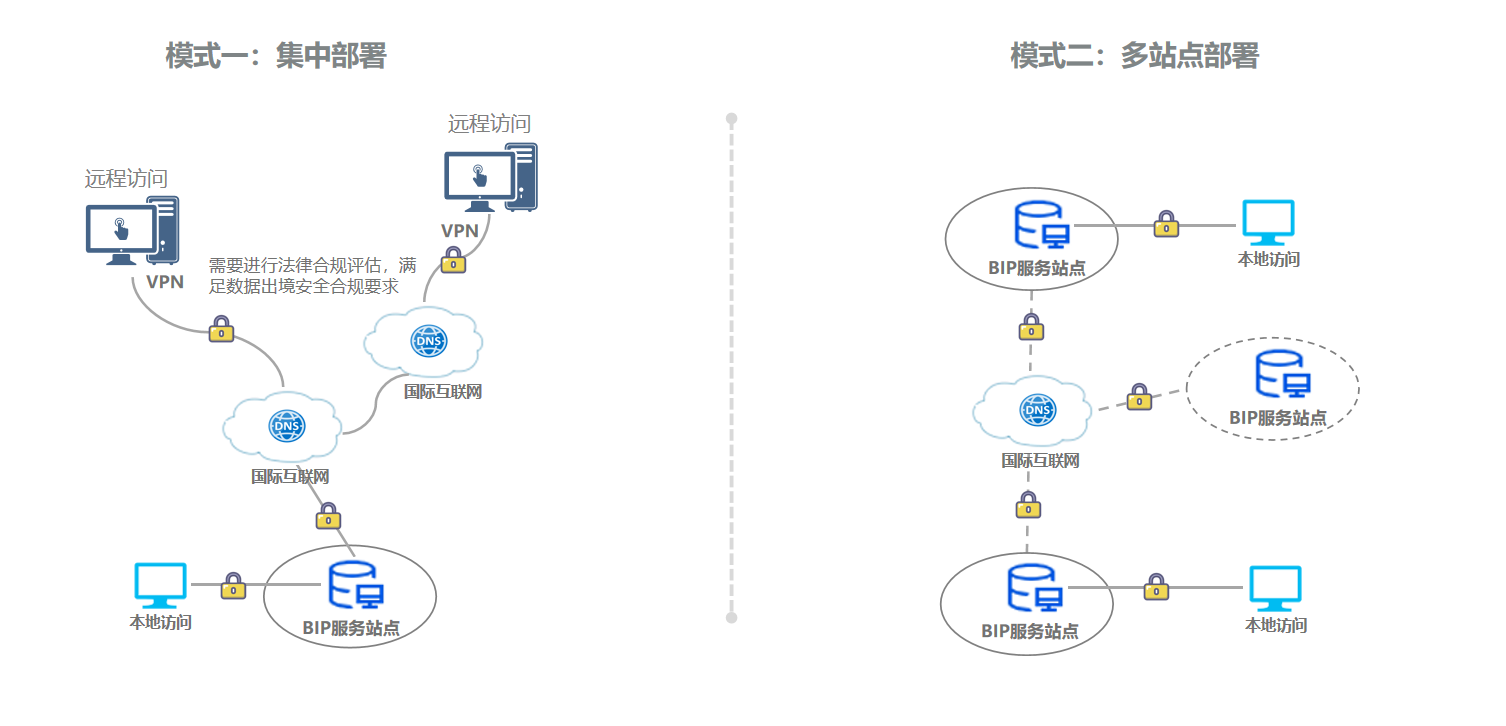
全球化部署模式
实现"数据留当地"的物理基础,是多站点部署。
多站点部署,简单说就是在不同国家或区域部署独立的站点,每个站点存管本地业务数据,满足数据驻留要求。总部站点则汇总各站点按统一口径处理后的经营数据,供全局管理和决策使用。
这里的关键设计是口径统一。即便数据分散在不同站点,只要科目、编码、核算逻辑、折算规则这些口径是全球一致的,汇总上来的数据就能直接拼在一起,不需要反复清洗和对齐。反过来,如果各站点口径不一,数据就算汇总上来也是一堆对不上的数字。
用友BIP支持多站点与混合部署模式,让企业能按数据合规要求安排站点的分布——哪些数据留在属地站点、哪些汇总到总部、总部站点与各站点之间怎么协同,都可以按业务和法规要求设计。
数据留当地解决的是"存",分级用数解决的是"看"。
分级用数的思路,是把数据按敏感度分层,再按角色和场景决定谁能访问哪一层。总部管理者看的是汇总层、经营层的数据,属地的具体明细由当地按权限管理。这样既满足"数据不出境"的合规要求,又让总部掌握经营全貌。
需要说明的是,这里只讲架构思路,不展开具体的技术实现细节。业内常提到"可用不可见"这类表述,但相关技术口径在现有资料里不够充分,本文不深入——架构层面把"数据分区、口径统一、权限分层"这三点想清楚,比堆技术名词更实际。
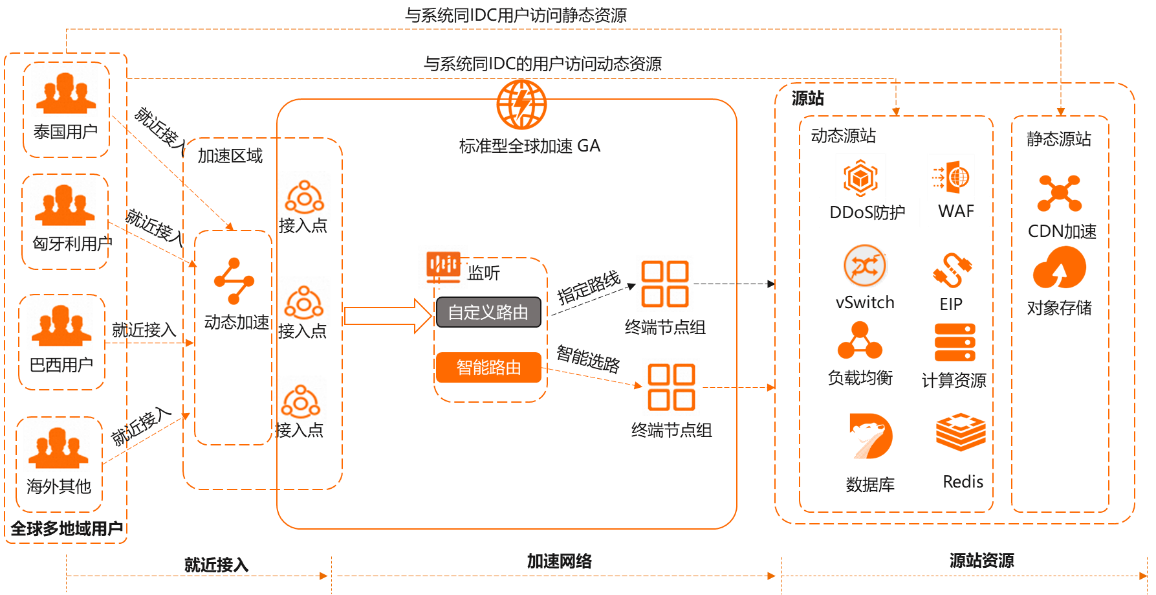
全球加速方案
数据本地存储的架构,不是把系统拆散就完事,还要兼顾三件事。
一是口径一致。前面说过,这是数据能汇总的前提。站点可以分散,口径必须统一,否则总部看到的还是一笔糊涂账。
二是访问体验。站点分散在不同国家,总部和属地之间的访问速度、协同效率不能掉链子。需要在网络和数据同步上做好设计,让分散的站点用起来像一套系统。
三是持续运维。站点越多,运维越复杂。架构设计时要考虑升级、监控、故障处理的统一性,避免每个站点都成了信息孤岛,维护成本失控。
这三件事做好了,多站点部署才是"既合规又好用",而不是"为了合规牺牲效率"。
数据本地存储架构不必一刀切。更务实的做法,是按数据敏感度决定分布:最敏感、法规要求最严的数据,留在属地站点;敏感度低、总部经营需要的数据,按统一口径汇总。
先识别哪些数据必须本地化、哪些可以汇总,是架构设计的第一步。把这个问题回答清楚,站点怎么布、权限怎么分,就有依据了。急于一次性把所有数据都本地化或都上收,往往两头不讨好。
能,但前提是口径统一且汇总机制设计到位。总部看的是按统一口径汇总后的经营数据,而非境外每条明细。明细留在当地满足驻留要求,汇总口径上收满足经营可见,两者并行不悖。
不是。多站点部署是在统一架构下的站点分布,组织、主数据、口径、权限这些共用能力是统一的,只是数据按合规要求分站点存管。它和"各国各建烟囱、各用一套系统"有本质区别。
分级用数的目的不是限制总部,而是让总部看该看的——汇总层、经营层的信息足够支撑决策,明细数据由属地按权限管理。这样既合规,又不牺牲总部的经营可见性。
小结:本地存储与总部可见并不矛盾,关键是把"数据存在哪里"和"谁能看什么"分开设计。靠多站点部署让数据留在当地、满足驻留要求,靠分级用数让总部按口径汇总、掌握经营全貌,同时守住口径一致、访问体验、持续运维三条线。先按数据敏感度定分布,比一刀切更务实。

