图 1|责任链条上的四个签字位,都要落到具体的人
2026 年 11 月 3 日,国家信息中心与中国经济时报的一篇文章把智能体的状态写成八个字:「强大而不稳定、能干活而不担责」,同时提出考核要从个人产出转向人智团队产出;同期一份产业报道里,安全团队给出的扩量前提是「audit-by-default」——默认可审计,才批准把智能体铺到更多部门(中国经济时报 2026-11-03;企业智能体产业应用报道 2026-11-03)。10 月 26 日人民邮电报报道的评测基准白皮书则把另一句写进共识:「AI 干活、人拍板」。
留痕不是为了存档,是为了有人签字。
很多系统的日志其实很全:请求、响应、耗时、报错一条不落。真出了一次错单,复盘会照样开不下去。原因不是没记录,是记录里看不出责任位置——这条任务是谁让它跑的、谁批准它能写这张表、中途哪一步由人确认过、最后谁验收认为结果可用。日志回答了「发生了什么」,没回答「谁该为它负责」。前者给工程师排障,后者才能给业务和管理层一个结论。
「AI 干活、人拍板」如果不落到具体岗位,就只是一句漂亮话。落到架构上,它意味着三件事:每个动作要能对应到一个发起主体,每个高风险动作前面要有一个人工确认位,每个结果后面要有一个验收人。三件事都不需要新模型,需要的是在流程设计阶段就把签字位画进去。
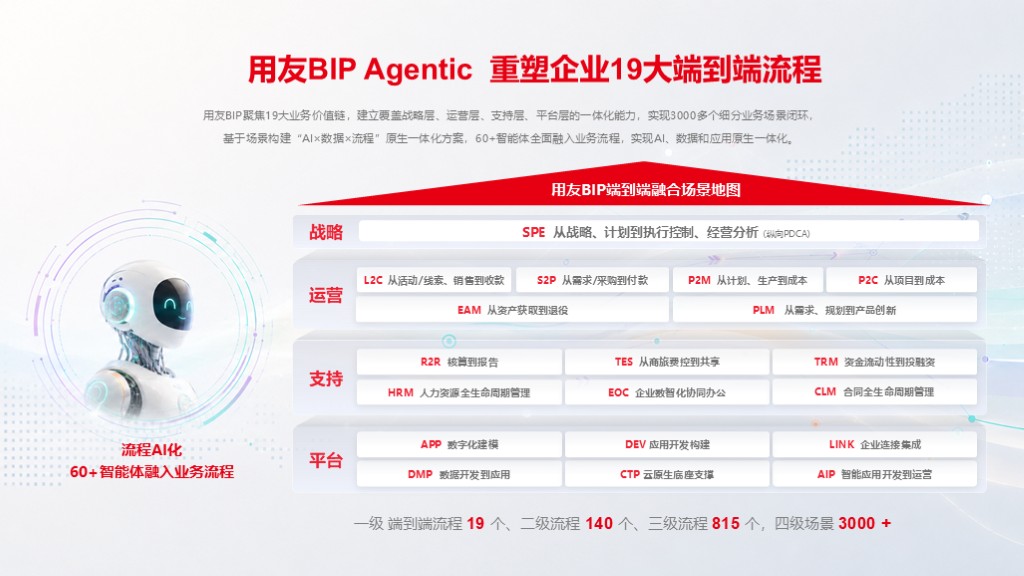
图 2|端到端流程覆盖度,责任位置要落在流程的具体节点上
一条业务动作从发起到落库,至少要经过四个位置。缺任何一个,判责时都会出现「这段不归我们」的真空。
| 位置 | 谁 | 签什么 | 系统里要留下什么 |
| 发起 | 业务用户或调度任务 | 我要做什么、基于哪份输入 | 发起主体标识、输入快照、任务 ID |
| 授权 | 业务负责人/安全合规 | 这个智能体能碰哪些数据、能不能写 | 智能体身份、可用范围、授权人与生效版本 |
| 审批 | 关键节点的人工确认人 | 这一步我看过、同意执行 | 审批人、时间点、看到的内容摘要、同意或驳回 |
| 验收 | 流程 负责人 | 这个结果可以进下游 | 结果校验记录、异常处理结论、验收人 |
四个位置里最容易被省掉的是验收。很多流程把「智能体执行成功」直接等同于「业务结果可用」,于是错单顺理成章流进下游;等月末对账发现差异,已经没有人记得当初是谁放行的。2026 年 11 月多份产业材料把关键系统写操作的强制留痕与回滚列为分级共识,本质上就是给「验收」补一个可回溯的落点:写之前有人确认,写错了能退回去。
还有一个容易混淆的点:授权和审批不是同一件事。授权是一次性的范围划定,说明这个智能体平时能做什么;审批是每次高风险动作前的逐笔确认。用授权代替审批,等于把「批准它能付款」当成「批准了每一笔付款」,责任链条在这里就断了。
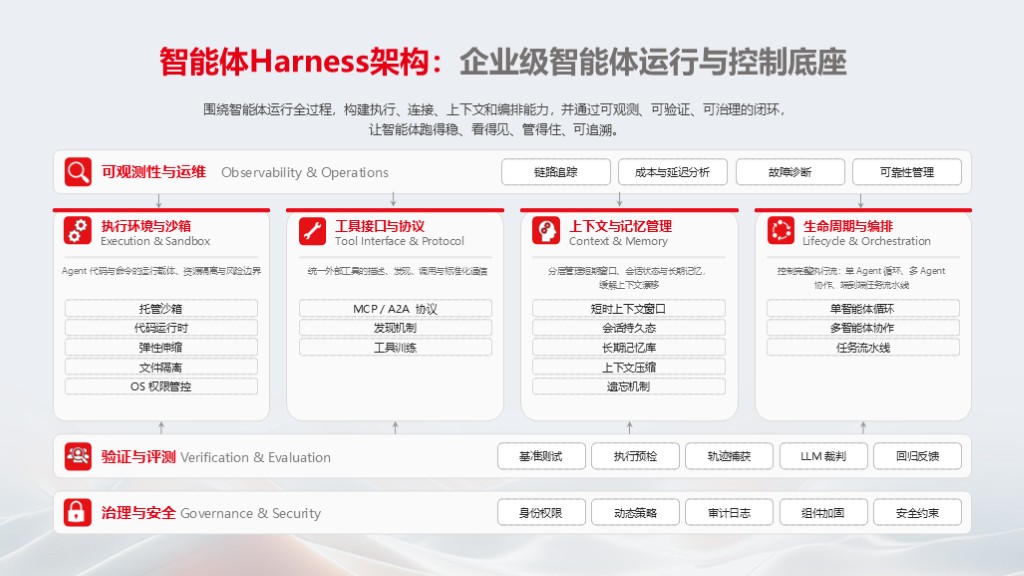
图 3|运行与控制底座,防护层位要前置到输入与编排阶段
「出了错谁担责」不能只靠事后翻日志,还要看事前有没有拦。2026 年 11 月 3 日的产业报道把运行时防护嵌进 Guardrail 层,并提到安全团队以「默认可审计」作为扩大 rollout 的前提。把这句话拆成可核对的层位,大致是这样:
| 层 | 拦什么 | 留什么证据 | 谁看得见 |
| 输入层 | 越权检索、注入式指令、超出申报范围的数据请求 | 拦截原因与输入摘要 | 安全/合规 |
| 编排层 | 工具调用超出授权清单、跨系统动作缺少关联 ID | 调用清单与编排版本 | IT/集成团队 |
| 写操作层 | 高风险动作未审批、写回对象与任务不匹配 | 审批记录与写回前后值 | 流程 负责人/内控 |
| 结果层 | 结果与预期不符、异常处理被跳过 | 结果校验与异常处置结论 | 业务验收人 |
四层的顺序不能随意调换。把防护全压在结果层,等于允许错误先写进业务系统再发现;2026 年 11 月 1 日实施的 YD/T 7173-2026 与 GB/T 47863-2026 提出八维可问责,其中可控性、可追溯性、可问责性都要求可验证的落地证据,前置层位的拦截记录正是这类证据。
低风险自主、中高风险人工审批的分级,在这张表里对应的是写操作层是否设置人工确认位。分级不是给系统打折,是把有限的人工注意力放到真会改坏数据的动作上。
防护装在越前面,复盘越短。
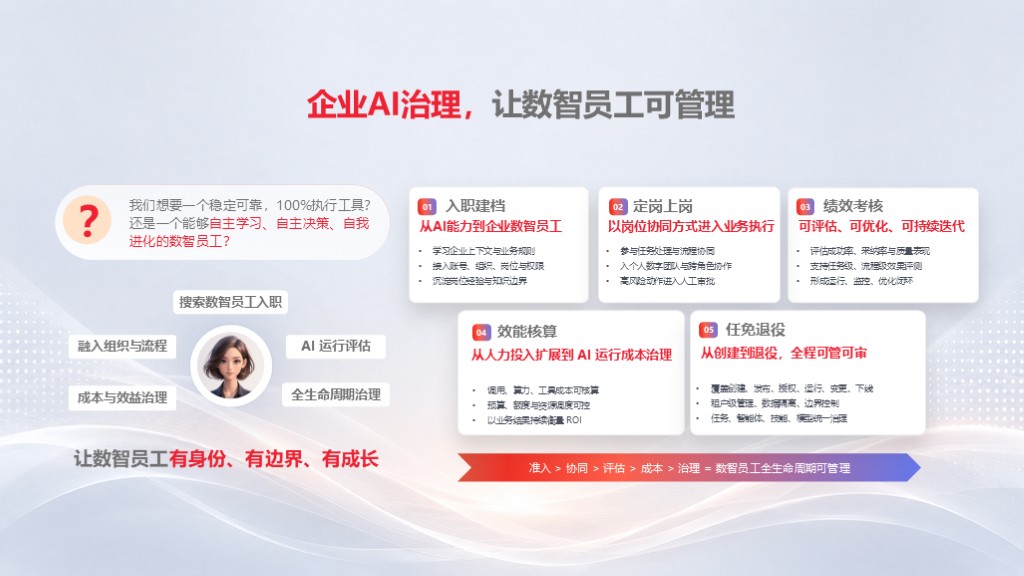
图 4|数智员工全周期管理,授权段要能查到身份与授权人
真到了复盘,需要的不是更多日志,是把三段连成一条线。
第一段是授权段:这个智能体是谁建的、谁批的、当时批准的数据范围与写权限是什么、跑的是哪一版编排。它回答「它有没有权做这件事」。第二段是执行段:这条任务基于哪份输入、引用了哪版知识与模型、调用了哪些工具、在哪个节点由谁确认过。它回答「当时到底发生了什么」。第三段是结果段:写进了哪张表、前后值差异是什么、谁验收放行、异常怎么处置。它回答「后果由谁确认可用」。
三段之间要有关联 ID 串起来。分段记在三个系统里、彼此对不上号的日志,看起来完整,判责时仍要花几天人工拼接。这里不展开日志字段清单,只强调一个判据:随机挑一条已完成的业务结果,让不在项目组里的安全同事自己往回反查,能在半小时内把三段连起来,才算可用。
2026 年 10 月 15 至 16 日发布的《工业和信息化领域人工智能安全评测框架(2026 版)》把「安全审计与可追溯」列为六大维度之一,与「权限边界与关键参数配置」「运行监测与可观测性」并列。三项放在一起看更清楚:权限划定边界,监测发现偏离,审计负责把偏离还原成一条能指到人的链。
留痕解决单笔判责,读数解决整体放行。2026 年 11 月 3 日腾讯新闻的一组产业材料把任务完成率、人工介入次数、单条任务耗时三项读数要求按部门切,它们同样可以作为责任链条是否有效的验收依据。
任务完成率异常下降,通常指向编排层或工具调用;人工介入次数上升,多半是写操作层的审批位设得过多,或模型在长尾任务上不稳;单条任务耗时 P95 拉长,要回头看是不是大量时间花在等待人工确认。三项都要按部门切——全局平均会把「某个部门全线转人工」抹平,而那个部门往往正是责任链条里验收位缺失的地方。
把读数和签字的责任人对上,管理动作才有着落。人工介入次数长期偏高,不是让业务方「再忍忍」,而是回到第一张表看审批位是否设错、授权范围是否过窄。国家信息中心文章提到考核要从个人产出转向人智团队产出,落到运行上就是这句:读数的改善也要有人负责,不能记在「系统」头上。
这套链条解决的是「谁为一次动作负责」,不解决「供应商该赔多少」这类合同责任,也不替代上线前的合规准入。后者要交的是权限映射、日志留存与第三方评测材料,属于放行条件;本文讲的是放行之后,日常运行里责任怎么落位。两件事分开做,别互相顶替。
也要承认一个边界:留痕再完整,也不能让智能体自己担责。「能干活而不担责」是这类系统的固有属性,制度设计能做的,是把责任明确地交回到人——发起的人、授权的人、审批的人、验收的人,四个位置都有名有姓。
是不是每个动作都要人工审批?
不是。低风险读操作可以自主,中高风险动作按分级设人工确认位,资金支付、合同签署、主数据变更这类关键写操作必须逐笔确认。全量审批会把人工介入次数推高,反而让真正的风险信号被淹没。
日志留得越全越安全吗?
先看能不能串成链。字段再多、留存再久,如果三段之间没有关联 ID,判责时仍要靠人工拼接。可用性判据是「不在项目组的人能不能半小时内反查完」。
出了错该找业务还是找 IT?
按四段位置分:输入与数据范围找业务负责人,工具调用与编排版本找 IT/集成团队,写回与审批找流程 负责人,结果放行找验收人。先定位断在哪一段,再谈责任,比笼统归给「系统问题」有用。
智能体自己生成的判断错了,谁负责?
发起与验收两个位置的人负责。模型输出不承诺 100% 准确,所以高风险动作前设确认位、结果后设验收位,正是把不确定性交回给人来兜底。
扩量到更多部门前,最该先补齐什么?
先把四个签字位在第一个部门跑通,再用三项读数按部门切做基线。没有基线就扩量,第二个部门出现差异时,分不清是责任链条没落地还是该部门业务本身更特殊。
本文观点

