图 1|权限边界要在检索之前生效,而不是等模型生成答案后再拦
让河北分公司的财务角色问一句「河南分公司这个月的营销费用」,系统该给什么?不是弹一句「无权访问」就够了——如果平台先把两份数据全文喂给模型,再让模型判断能不能回答,泄露在生成答案之前就已经发生。
2026 年 10 月发布的《工业和信息化领域人工智能安全评测框架(2026 版)》把「权限边界与关键参数配置」列为六大评测维度之一,同一时期信通院依 AIIA/T 0293-2026 颁发了首个 Claw 类智能体风险管理专项评测证书。评测的是配置和证据,不是承诺。
这条链路只有五段,但每段都得现场跑一遍。
第一处是检索阶段。知识库、向量库、数据权限如果各管各的,智能体拿到的上下文就已经越过了用户本来的可见范围。检索阶段做过滤和生成阶段做拒绝,是两件完全不同的事。
第二处是工具调用。智能体拿到一个写接口,若只校验「接口能不能调」,不校验「这个身份能不能改这条记录」,就等于把业务系统的授权体系绕过去了。提示词里写「不要修改他人数据」不构成控制。
第三处是身份脱节。智能体用自己的服务账号运行,所有操作记在同一个身份下,事后分不清是张三发起的还是定时任务发起的。2026 年 11 月蚂蚁数科在香港金融科技周发布的 KYA(Know Your Agent)模块把「这个智能体是谁、能做什么」提到与 KYC/KYB 同等级,指向的正是这件事。
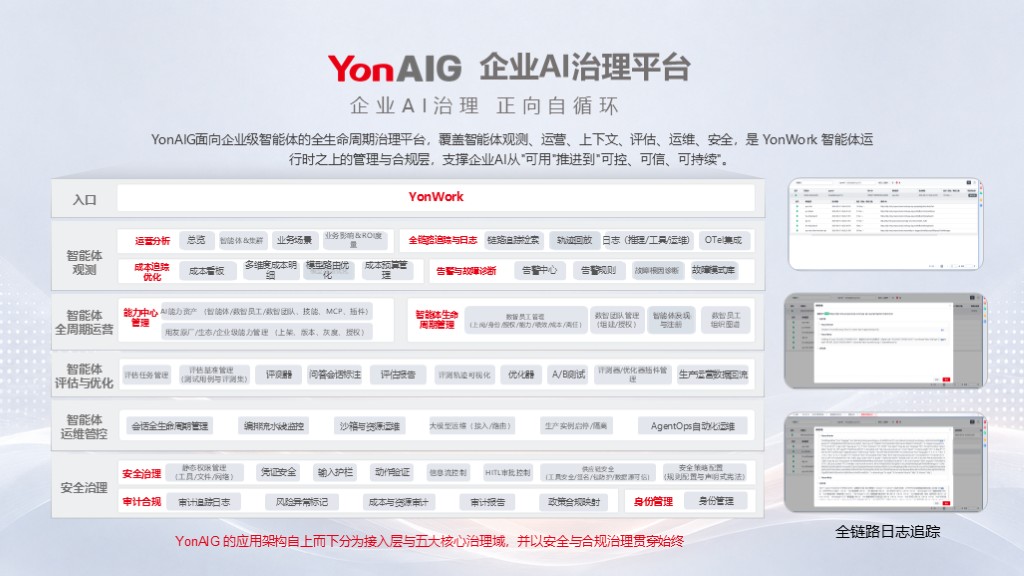
图 2|企业 AI 治理平台的五大治理域,安全与合规贯穿观测、评估、运维各层
企业统一身份认证、组织权限、岗位职责要能一路传到智能体的运行时。判据很朴素:用户有什么权限,数智员工才能使用什么权限;员工不能访问的数据,数智员工同样不能访问;员工无权执行的动作,AI 不能绕过流程直接执行。
YonWork 在身份与权限层面的口径就是这条继承原则,并接入企业统一身份认证、组织权限和岗位职责体系。现场核验别看登录页,看两个不同岗位账号在同一会话里读同一份数据时的返回差异,再查后台记录里操作主体写的是谁。
「支持权限体系」这句话太便宜了。要问的是粒度:能不能按组织、按角色、按字段、按行过滤;知识库文档权限与业务数据权限是否同一套;跨系统查询时权限映射会不会在中间某一跳丢掉。
2026 年 10 至 11 月多份政企 AI Agent 选型清单把行列级权限、日志留存 180 天、断网压测加外联清单、推理与向量化是否全内网列为硬性过滤条件,并明确「数据物理隔离不出域」对金融、能源、政务、医药是准入项而非加分项。另有 80.3% 的受访 CIO 表示面临数据本地化约束(《2026 中国企业级 AI 实践调研分析年度报告》,400 多位 CIO、10 多个行业)。
还要单独核一次部署口径:平台本地部署,不代表外部模型调用、日志、备份和远程支持一定不出域。逐项列出模型推理、存储、日志、备份、运维数据的处理位置和安全约定,比一句「私有化」有用得多。
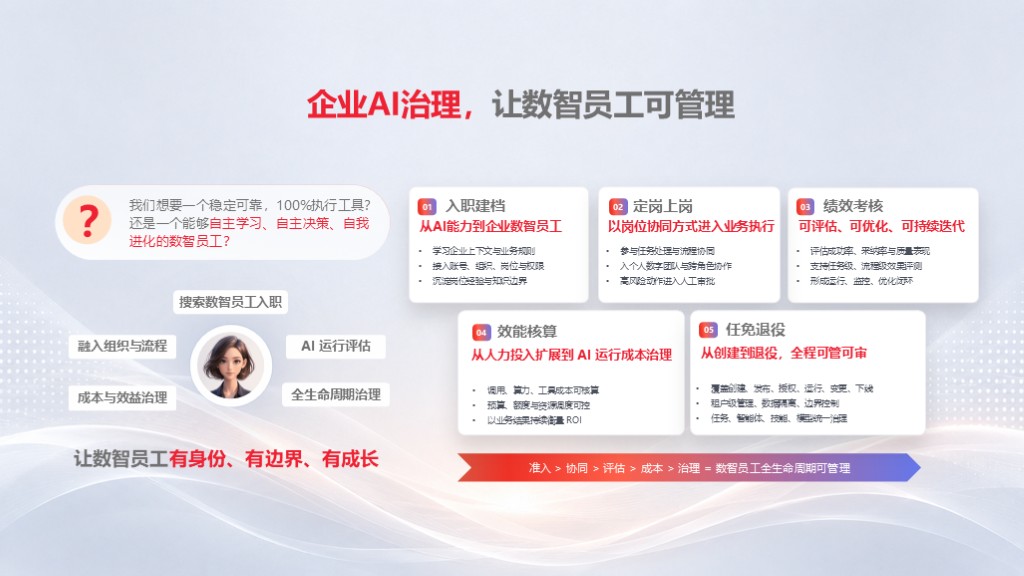
图 3|让数智员工有身份、有边界、有成长:从入职建档到任免退役的全周期管理
只读查询、低风险写入、高风险动作要三档分开。低风险写入至少要有参数校验和重复提交处理;高风险动作(资金支付、合同签署、生产控制、额度调整)必须保留人工确认节点,也就是 HITL(Human-In-The-Loop)审批。
2026 年 11 月《2026 中国 AI 智能体产业应用标杆案例蓝皮书》相关报道给出过分级共识:低风险自主、中高风险人工审批、关键系统写操作强制留痕与回滚。同一时期的政策解读还把「唯一身份标识与关键节点人工审批」列为验收四道关之一(可托付、可衡量那一组)。落到现场就是三个问题:写之前谁批、写失败怎么退回、重复触发会不会写两遍。
运行时攻击面也得在这一段问清。2026 年 11 月 CrowdStrike 把运行时防护原生嵌入 AWS Bedrock AgentCore Guardrails 与 Claude Cowork,防护提示词注入、敏感数据外泄、恶意行为被放进 Guardrail 层而非独立部署;安全团队提出「audit-by-default」才批准扩大 rollout。防线装在哪一层,比装了几个功能更值得写进合同。
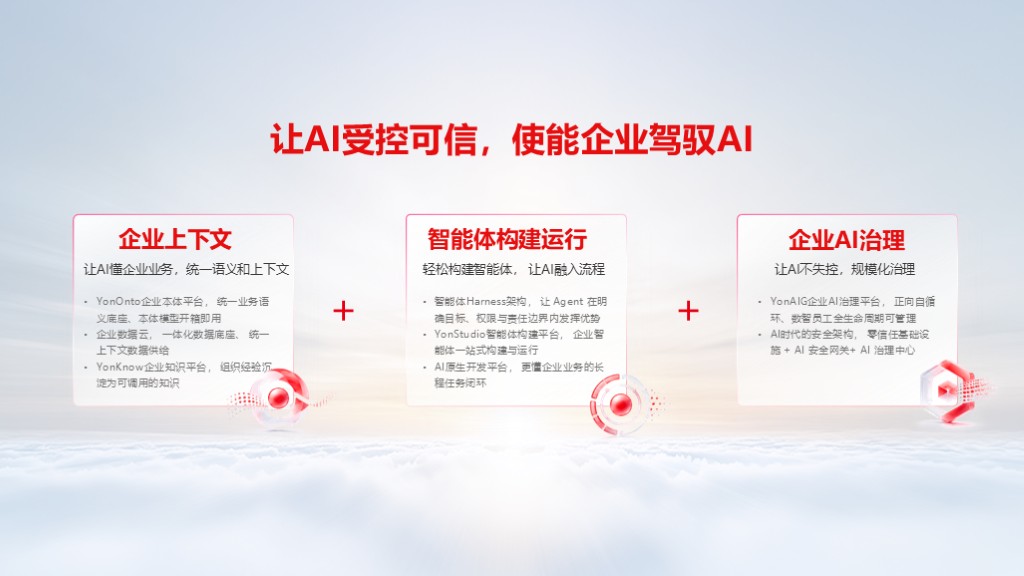
图 4|企业上下文、智能体构建运行、企业 AI 治理三段,留痕要能反查到每一段
该记录的字段有明确清单:用户身份、输入及引用来源、模型与配置版本、工具调用、审批和处理结果,必要时保存可供审核的决策依据摘要。YonAIG 的运行记录可与业务日志配合追溯,但日志范围与保留时间需要在项目里明确写定,不能默认「都有」。
验收动作只有一条:随机挑一条已经完成的业务结果,让安全团队自己反查数据、授权和操作过程,检查关键记录能不能对应起来。只展示最终答案的审计页面,过不了这一关。
这里有个容易混的点:资金业务里「多流合一全程可溯」是业务追溯,不是 AI 行为审计。前者证明钱怎么走,后者证明智能体为什么这么走,两套日志要能对上,不能互相顶替。
岗位变动、权限收回、智能体下架时,工具访问、定时任务、已授权的技能、记忆里的数据是否同步停止?下线处置与资源释放在 2026 版安全评测框架里是六大维度之一,不是运维的附带动作。
一个可执行的检查:把某个测试账号的权限收回,再观察它名下的智能体是否还能触发原有工具;把智能体停用,再检查定时任务是否仍在运行、日志是否还能导出、责任能否追到原授权链条。
「私有化部署了,数据就没出域。」——前面说过,要逐项核实推理、日志、备份、运维数据的位置,并做断网压测与外联清单验证。
「有引用来源,答案就一定对。」——引用是复核线索,不是正确性保证。知识检索、本体、规则校验和人工监督只能降低错误风险,官方百问百答里也明确写了不能承诺百分之百准确。
「先把功能上线,治理后面补。」——没有治理,企业往往只能让 AI 停留在低风险试用阶段,难以进入资金、合同、采购、生产和监管等核心业务。治理不是上线后的收尾,是准入门槛。
采购合同里该落成哪几条?
身份继承原则、行列级权限粒度、日志字段清单与保留时长、高风险动作人工确认、升级不破坏且可回滚、停用与资源释放、第三方评测维度对应的验收项。2026 年 11 月 1 日同步实施的 YD/T 7173-2026 与 GB/T 47863-2026 提出八维可问责,每一项都要求可验证落地证据,正好可以按维度逐条映射。
越权测试怎么设计才有效?
至少两组:跨组织查询、跨岗位写操作。再补一组「用低权限账号发起高权限任务」,看系统是拒绝、转人工还是绕过去了。答案要记录后台日志里的操作主体,不能只看前端提示。
智能体也要「验明正身」吗?
要。除了用户身份,还要确认每个智能体的唯一身份标识、可用的技能与工具清单、版本和负责人。KYA 之所以在 2026 年 11 月被单独提出来,就是因为「谁在用」和「谁在干」是两件事。
提示词注入该怎么防?
别指望提示词本身。输入护栏、工具签名与防篡改、数据源可信校验、动作验证与信息流控制、输出项目控制,加上高风险操作的 HITL,构成事前事中事后三段防线。2026 年 10 月信通院「智能体互联网治理—智能体安全网关技术能力评估」把身份可验、权限最小、风险可察、行为可控、全程可溯列为要点。
出了错,日志能替我们定责吗?
不能。平台日志有助于定位问题,但不能替代责任约定。按场景明确复核人、纠错渠道和升级处理方式,涉及对外承诺和关键业务判断时,使用者与审核人仍需履行相应职责。
本文观点

