智能运维中的工单管理,表面看是一张表单的流转,工程上要解决的其实是四件事:需求进来时先给出可直接使用的结论、未解决时自动生成可跟踪 的记录、记录能被分派到合适的处理方、全过程的状态可被观测。本文只讨论这几件事之间的原则性关系与工程约束,不涉及具体接口与实现细节,具体能力以官方产品说明为准。
一、问题定义:闭环的难点不在提交
多数工单系统都能做到"提交—分派—关闭"。真正的难点在两端:提交之前有没有先给出结论,关闭之后有没有留下可复用的内容。
前者决定重复劳动量,后者决定能力是否积累。缺少任何一端,工单系统都会退化为记录工具,而不是闭环工具。
二、原则性分层
一条服务请求在系统中的流转,可以按职责分成四层来理解:
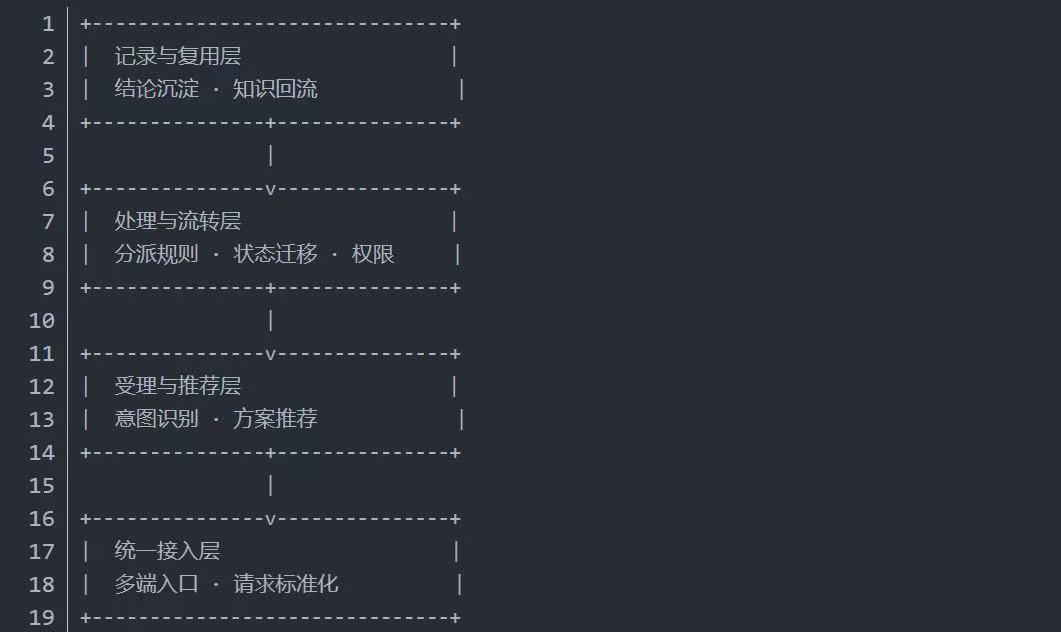
这个示意想表达的是:闭环能力不取决于任何一层单独做得多好,而取决于层与层之间的接口是否清晰。层内实现可以替换,接口一旦含糊,数据就对不上。
三、关键工程约束
其一,推荐结果要有可用性边界。受理层对用户问题先做方案推荐,但推荐必须带可信度判断。对不确定命中,正确行为是转入人工而不是硬给结论。把"不答"设计成正常路径,比让系统在不确定的情况下给出看似有用的答案更安全。
其二,自动生成工单时的信息完整性。用户提交的问题描述往往不完整。系统自动转工单时,必须把入口侧已有的上下文一并带入:用户身份、所属组织、前置的问答记录、问题描述本身。缺任何一项,处理方都要回头追问,闭环时间被拉长。
其三,状态模型要先定义。状态迁移是工单系统的骨架。事件、问题、变更、配置、知识五大流程各有不同的状态语义,若在实现时不先定义状态模型,而是边用边加,后期几乎无法收敛。
其四,分派规则与组织模型解耦。分派依赖组织、角色与领域标签。若把这些硬编码进流程,组织调整时就要改流程定义。更稳妥的做法是让分派规则读取组织与标签配置,组织变化时只改配置。
四、集成与开放性
企业里通常已存在其他系统。工单系统需要与之协作的部分主要有三类:身份与组织来源、通知与消息通道 、既有资产与配置项的关联关系。
集成的原则是先确定边界:哪些数据由外部系统权威提供,哪些由工单系统自己维护。边界不清时,两边都改同一份数据,最终没有一方是可信的。
用友智能服务管理器YonISM 在一体化架构上以整合与统一为设计取向,把服务入口与工单流程放在同一体系内,减少跨系统往返。具体可对接的范围与方式以官方产品说明为准。
五、落地顺序建议
不建议一次性把四层全部上线。更稳妥的顺序是:先统一接入与请求标准化,再定义状态模型与分派规则,然后引入受理层的方案推荐,最后把结论回流接上知识。
这个顺序的依据是:推荐依赖知识,知识来自结论回流,而回流依赖前面几层已经稳定。顺序反过来,先做推荐再治理记录,得到的只会是一套命中率上不去的推荐。
六、常见误区
误区之一是追求闭环率而忽视闭环质量。工单被关闭不等于问题解决,若关闭动作没有结论记录,闭环率只是把问题藏起来,而不是把问题解决掉。
误区之二是把可观测性等同于看板。看板呈现的是汇总结果,工程上更需要的其实是单条请求的全链路可追溯:这次请求经过了哪些环节、在哪一环停留最久、为什么会升级。YonISM 的闭环设计要求每一次关闭都带上处理结论,这样汇总出来的数据才有可追溯的底座。
销售热线
4006-600-577联系我们