智能运维服务一旦跨团队,问题就不再只是"谁来处理",而是"信息在团队之间怎么不失真地流转"。本文只讨论这类信息交接的原则性工程约束,不涉及具体接口与实现,具体能力以官方产品说明为准。
一、问题定义:交接失真的三种典型形态
跨层协同中的信息失真通常有三种形态,且都不是态度问题。
其一是描述丢失。一线在转派时只留下"用户反馈系统慢"这类结论,原始现象、发生时间、影响范围没有随单流转,接收方需要重新问一遍。
其二是状态分裂。各层在各自的工具里维护处理状态,上游看到的"处理中"与下游实际的"等待复现"不是同一个意思,管理层拿到的口径无法对齐。
其三是结论断链。三线给出了处理结论,但这个结论没有回到一线的可查范围,同类问题下次仍然从零开始。
二、原则性分层架构
下面是一个原则性的分层示意,用于说明信息在哪几处需要被固定下来,不代表真实部署拓扑。
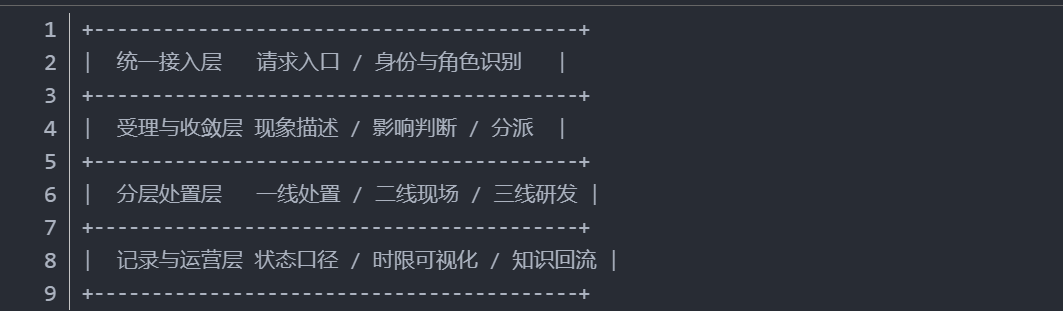
这个示意想表达的是:智能运维的分层处置层本身不是难点,难点在它与上下两层的接口。向上,受理与收敛层要交出一份可判断的材料;向下,记录与运营层要把各层的状态统一成一套口径。
三、关键工程问题
交接材料的结构化。升级时随单携带的信息应当被固定下来,而不是依赖处理人写一段自由文本。可固定的最小集合包括:现象与期望行为的差异、影响范围、首次发生时间、已排除的原因、可复现条件。结构化不是为了好看,是为了让接收方能够判断"该不该我处理"。
状态的单一事实来源。若各层各自维护状态,跨层统计必然失真。可行做法是让工单成为状态载体,分层动作作为工单上的事件追加,而不是另起一条记录。
时限与责任的可见。响应时限只有在"当前停留在哪一层、已停留多久"可见时才有约束力。这要求流程引擎在分派与升级时写入时间戳 ,并在运营侧呈现分层停留时长,而不是只统计总时长。
结论的知识化回流。三线的处理结论需要经过一次结构化提炼才能进入知识库,否则只是一段聊天记录。提炼的最小要素是:适用条件、判断依据、处理动作、不适用情形。缺少适用条件,知识库会在下一次被错误引用。
四、集成与开放性
跨团队协同很难只在一个系统内完成,通常会涉及既有服务系统与第三方系统。这里的工程约束是两条:一是身份与权限的映射要能收敛,即外部团队在系统内看到的范围应与其职责一致,而不是共享一个高权限账号;二是集成后仍要保持请求入口的统一,避免因接入多个系统而让用户重新面对多个入口。
用友智能服务管理器YonISM 在集成层面支持与用友 NC、NC Cloud、YonBIP 等服务系统协同,并可接入第三方系统,通过组织、权限、流程与档案的配置适配多组织、多角色场景。上述为原则性能力描述,具体适配边界以官方产品说明与售前评估为准。
五、工程落地建议
不建议在智能运维项目里一次性把分层全部上线。更稳妥的顺序是:先把交接材料的结构固定下来,让升级带上可判断的信息;再把状态口径统一到工单上;然后才做分层停留时长的可视化 ;知识回流放在最后,因为它依赖前三步产生的结构化数据。
如果顺序反过来,先做报表再治理记录,得到的只会是一套口径对不上的图表。这也是很多平台上线后"数据都有、决策仍靠经验"的原因。用友智能服务管理器YonISM 以工单服务为载体承载分层动作,为上述顺序提供落点,但顺序本身仍需要企业自己执行。
销售热线
4006-600-577联系我们